学SQL JOINS看这一篇文章就够了
学SQL JOINS看这一篇文章就够了
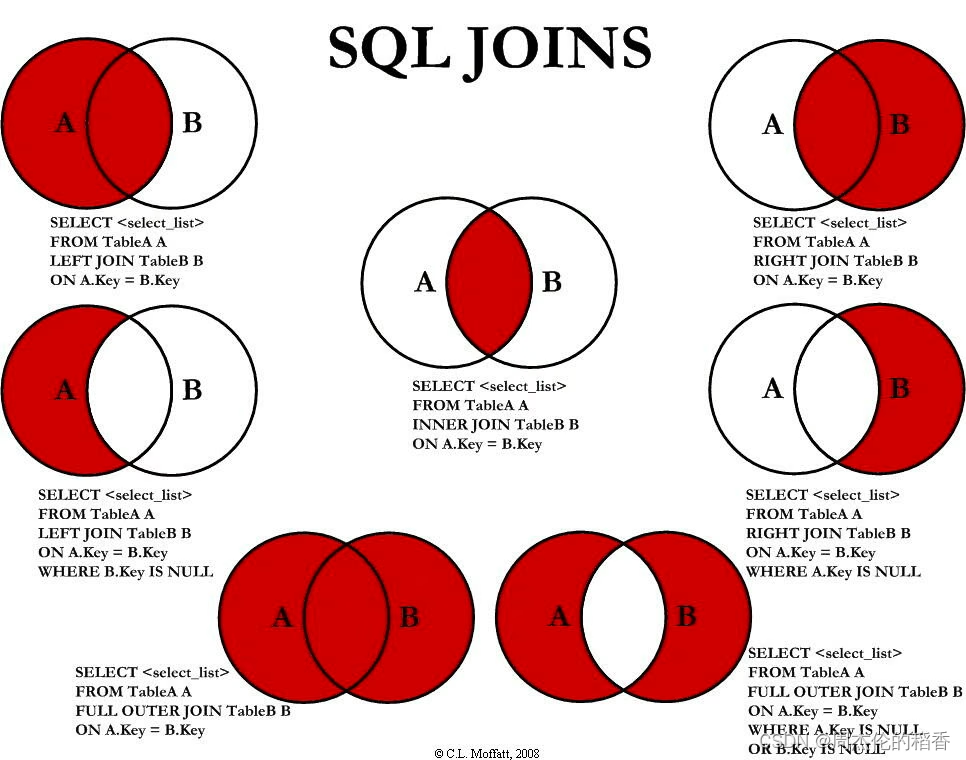
Eucalyptus在数据库中,连接 Join 是用于将两个或多个表中的数据关联起来的操作。连接操作有多种类型,其中包括内连接和外连接。内连接的话只有一种而外连接的话有六种,当然还有一种连接叫做交叉连接。
- 内连接:join , inner join
- 外连接:left join , left outer join , right join , right outer join , union
- 交叉连接:cross join
下面以实例进行分析
1 | #首先创建两张表a和b |
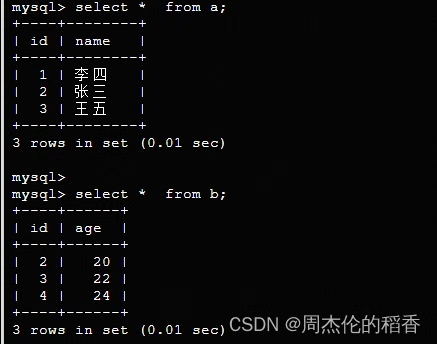
两张表格式如下:
内连接
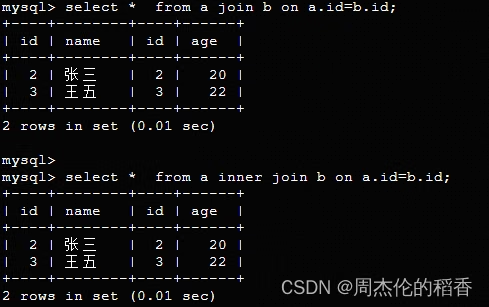
inner join 或者join 等同于inner join
语法:
1 | select * from a join b on a.id b.id; |
结果:
应用场景:
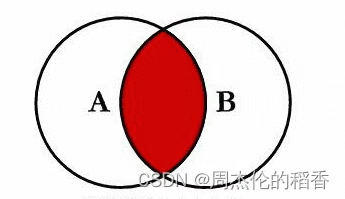
这种场景下得到的是满足某一条件的A,B内部的数据;正因为得到的是内部共有数据,所以连接方式称为内连接。
外连接
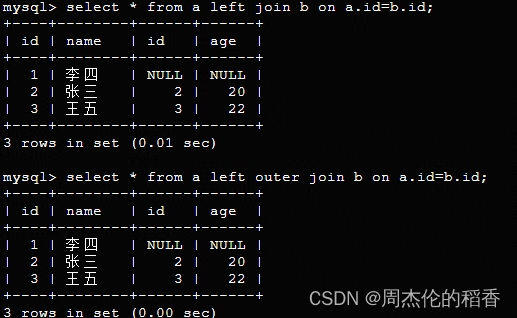
left join 或者left outer join(等同于left join)
语法:
1 | select * from a left join b on a.id b.id; |
结果:
结果如下,TableA中B不存在的记录填充Null
应用场景:
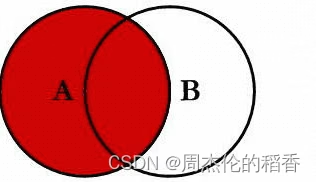
这种场景下得到的是A的所有数据,和满足某一条件的B的数据。
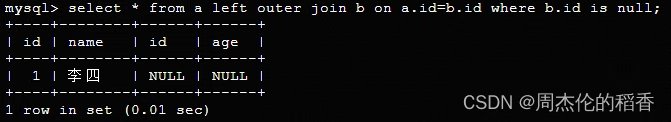
[ left join 或者left outer join(等同于left join) ] [ where B.column is null ]
语法:
1 | select * from a left outer join b on a.id b.id where b.id is not null; |
结果:
left join表a的数据全部显示,匹配表b的数据也显示,而b.id再次过滤掉 表b的id为空的
应用场景:
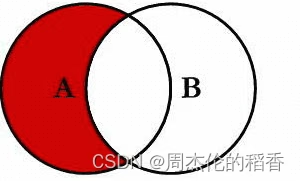
这种场景下得到的是A中的所有数据减去 与B满足同一条件 的数据 ,然后得到的A剩余数据。
right join 或者right outer join(等同于right join)
语法:
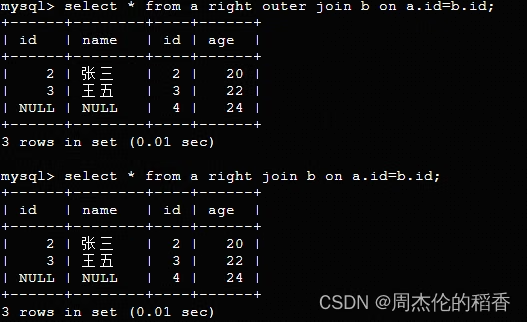
1 | select * from a right outer join b on a.id b.id; |
结果:
TableB中A不存在的记录填充Null
应用场景:
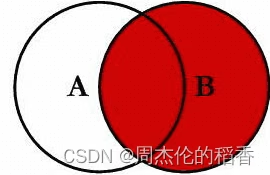
这种场景下得到的是B的所有数据,和满足某一条件的A的数据。
[ right join 或者right outer join(等同于right join) ] [ where A.column is null ]
语法:
1 | select * from a right join b on a.id b.id where a.id is not null; |
结果:
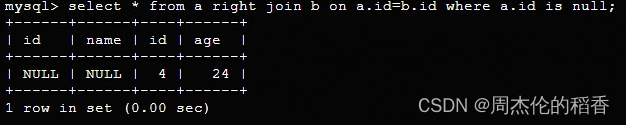
应用场景:
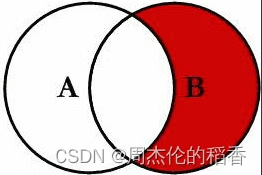
这种场景下得到的是B中的所有数据减去 与A满足同一条件 的数据“,然后得到的B剩余数据。
full join mysql不支持,但是可以用 left join union right join代替
语法:
1 | select * from a left join b on a.id b.id union select * from a right join b on a.id b.id; |
结果:
union过后,重复的记录会合并 id为2,3,4的三条记录
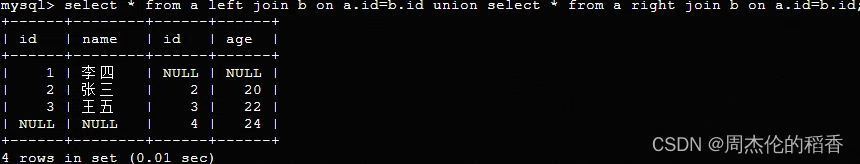
应用场景:
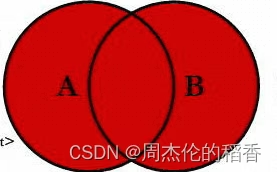
这种场景下得到的是满足某一条件的公共记录,和独有的记录。
full join is null mysql不支持,但是可以用 left join is null union right join is null代替
语法:
1 | select * from a left join b on a.id b.id where b.id is null union select * from a right join b on a.id b.id where a.id is null; |
结果:
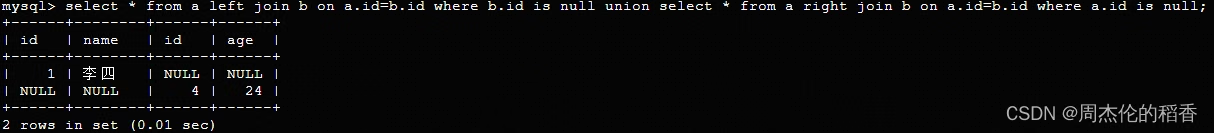
应用场景:
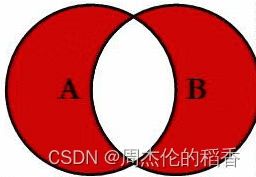
交叉连接
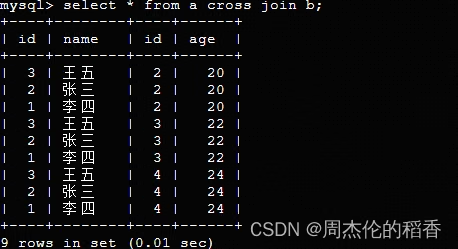
cross join
语法:
1 | select * from a cross join b; |
结果:
cross join where
语法:
1 | select * from a cross join b where a.id b.id; |
结果:
这种情况下实际上实现了内连接的效果
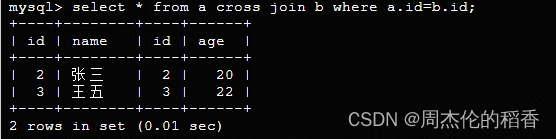
注意事项
- 一般cross join后面加上where条件,但是用cross join on也是被解释为cross join where 显示连接 ;
- 一般内连接都需要加上on限定条件,如果不加会被解释为交叉连接;
- 如果连接表格使用的是逗号,会被解释为交叉连接 隐式连接 。
注:隐式连接 Implicit Join 会出现数据冗余和性能问题,主要是因为它使用逗号分隔表名的方式进行连接,而没有明确指定连接条件,这样就会导致以下两个问题:
- 数据冗余问题: 隐式连接会产生笛卡尔积,即将左表的每一行与右表的每一行进行组合,然后返回所有可能的组合结果,包括那些并不符合连接条件的组合。这就会导致结果集中出现多余的数据,从而产生数据冗余的问题。
- 性能问题: 隐式连接的查询效率很低,因为它会处理大量的无用数据,浪费了系统资源和时间。当表a和表b的记录数都很大时,隐式连接会产生庞大的临时表,消耗大量内存和CPU资源。此外,由于没有明确指定连接条件,数据库引擎会对每一个可能组合进行比较,这会进一步降低查询效率。
问题分析
EXPLAIN扫描行数不同
当我们使用explain执行计划,分析select * from a join b on a.id b.id;语句时会发现两张表的数据基本相同,通过唯一主键索引关联,数据是一对一的,为什么扫描的行数不同。
语法:
1 | explain select * from a join b on a.id b.id; |
结果:
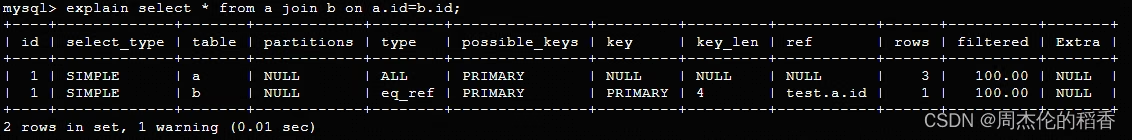
分析:
sql join执行流程
- 从a表取出一行
- 从取出的这一行取出字段1,然后到表b中查找a.id b.id
- 取出从表b中获取到的数据,跟从表a中的数据组成一行,作为结果集的一部分
explain执行计划的第一行,实际上就是表a的全表扫描,扫描行数比较大
执行计划的第二行,实际代表的是用表a去表b中查找数据,这里用到了索引,所以扫描行数是一行。
SQL JOINS执行顺序
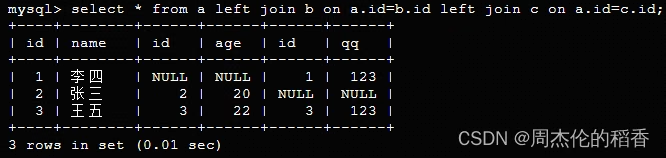
- A left join B 返回 A 表数据,附带 B 表中符合条件的数据
- A left join B right join C
- A left join B 假设等于结果 AB
- AB left join C 返回 AB ,附带 C中符合条件的数据
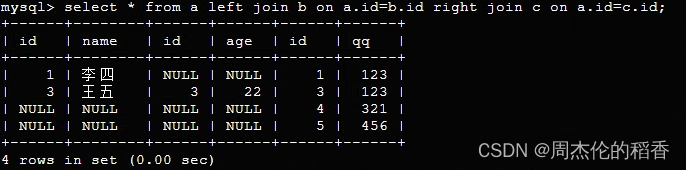
- A left join B 返回 A 表数据,附带 B 表中符合条件的数据
- A left join B right join C
- A left join B 假设等于结果 AB
- AB right join C 返回 C ,附带 AB 中符合条件的数据
通过上述两个sql可以看到sql join的执行顺序