Twikoo 评论反垃圾实战:人机验证、频率、词表与 LLM 四层防线

Twikoo 评论反垃圾实战:人机验证、频率、词表与 LLM 四层防线
Eucalyptus一、凌晨的刷屏
博客的评论区一直是”开着但没人管”的状态,直到某天早上看日志,发现凌晨被刷了一波:
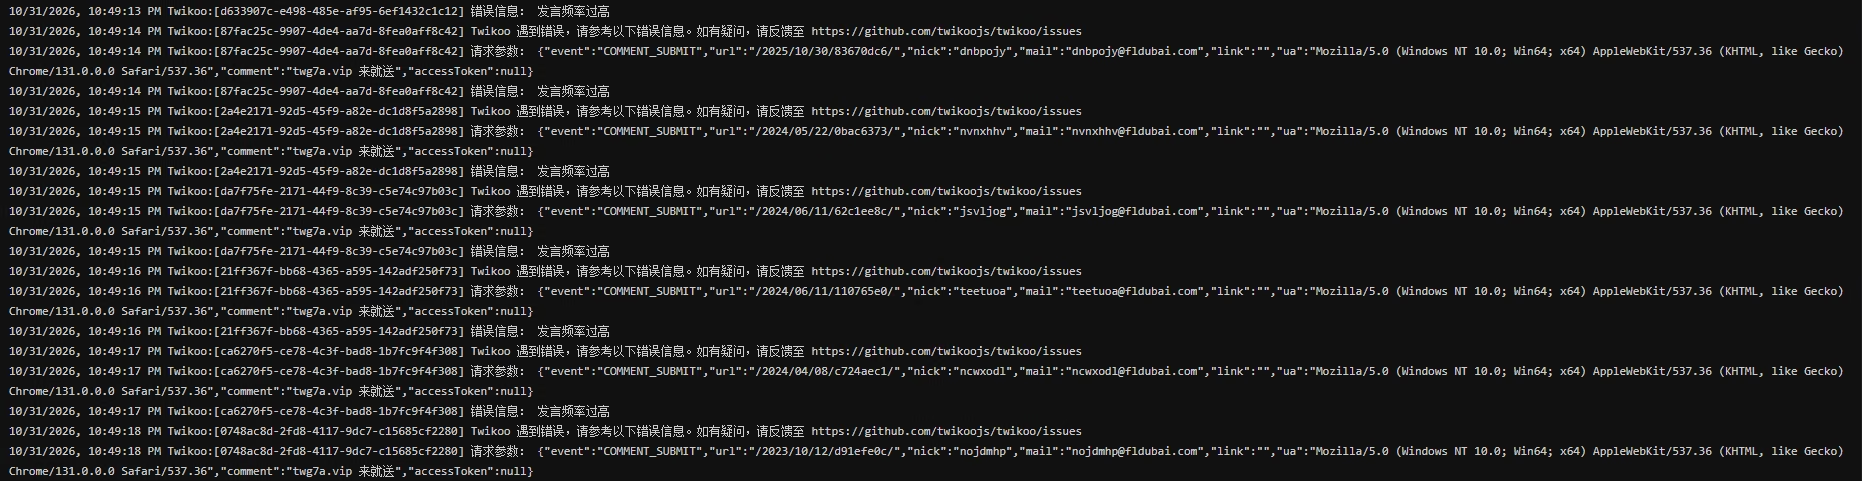
用的是同一套 Chrome UA,评论内容一模一样,accessToken 全是 null —— 典型的脚本灌水,不执行 JS,直接 POST 一个 JSON 到 Twikoo 接口。
好在 Twikoo 默认有频率限制,这一波全被”发言频率过高”挡在了外面。但这也说明一件事:默认配置只是在苟着,稍微调松一点,或者换个 IP 池,评论区就守不住了。
于是花了一上午,把反垃圾从头配了一遍。
二、关键词拦不住的那一类
垃圾评论其实有两类,很多人只防了第一类:
| 类型 | 长相 | 关键词能挡吗 |
|---|---|---|
| 流量型 | 脚本连发、同一句话刷几十个页面 | ✅ 能 |
| 语义型 | 「写得真好,欢迎回访我的站点 xxx.com」 | ❌ 挡不住 |
第二类是人(或者半自动工具)写的,不带任何敏感词,但意图明确。它过得了关键词,也过得了频率限制——因为一天就那么几条。
所以要分层:便宜的规则挡量,贵的模型挡质。
三、四层防线
最后落地的方案是这样:
| 层 | 手段 | 挡什么 |
|---|---|---|
| 1 | 人机验证(极验 / Cap) | 不执行 JS 的脚本 |
| 2 | 频率限制 | 换着页面刷的脚本 |
| 3 | 屏蔽词 / 违禁词 | 带明显关键词的垃圾 |
| 4 | LLM 语义检测 | 不带关键词的软广告 |
再加上 HIDE_SPAM=true,被判为垃圾的评论前台一律不可见。
四、第一层:人机验证
4.1 先配了极验
Twikoo 后台选「极验 Geetest」,填两个值就行:
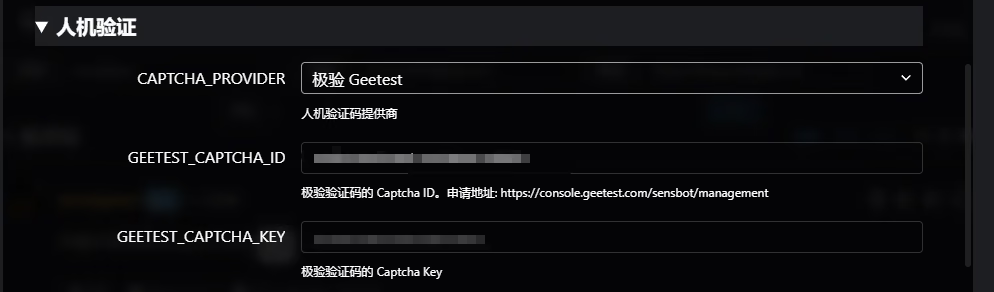
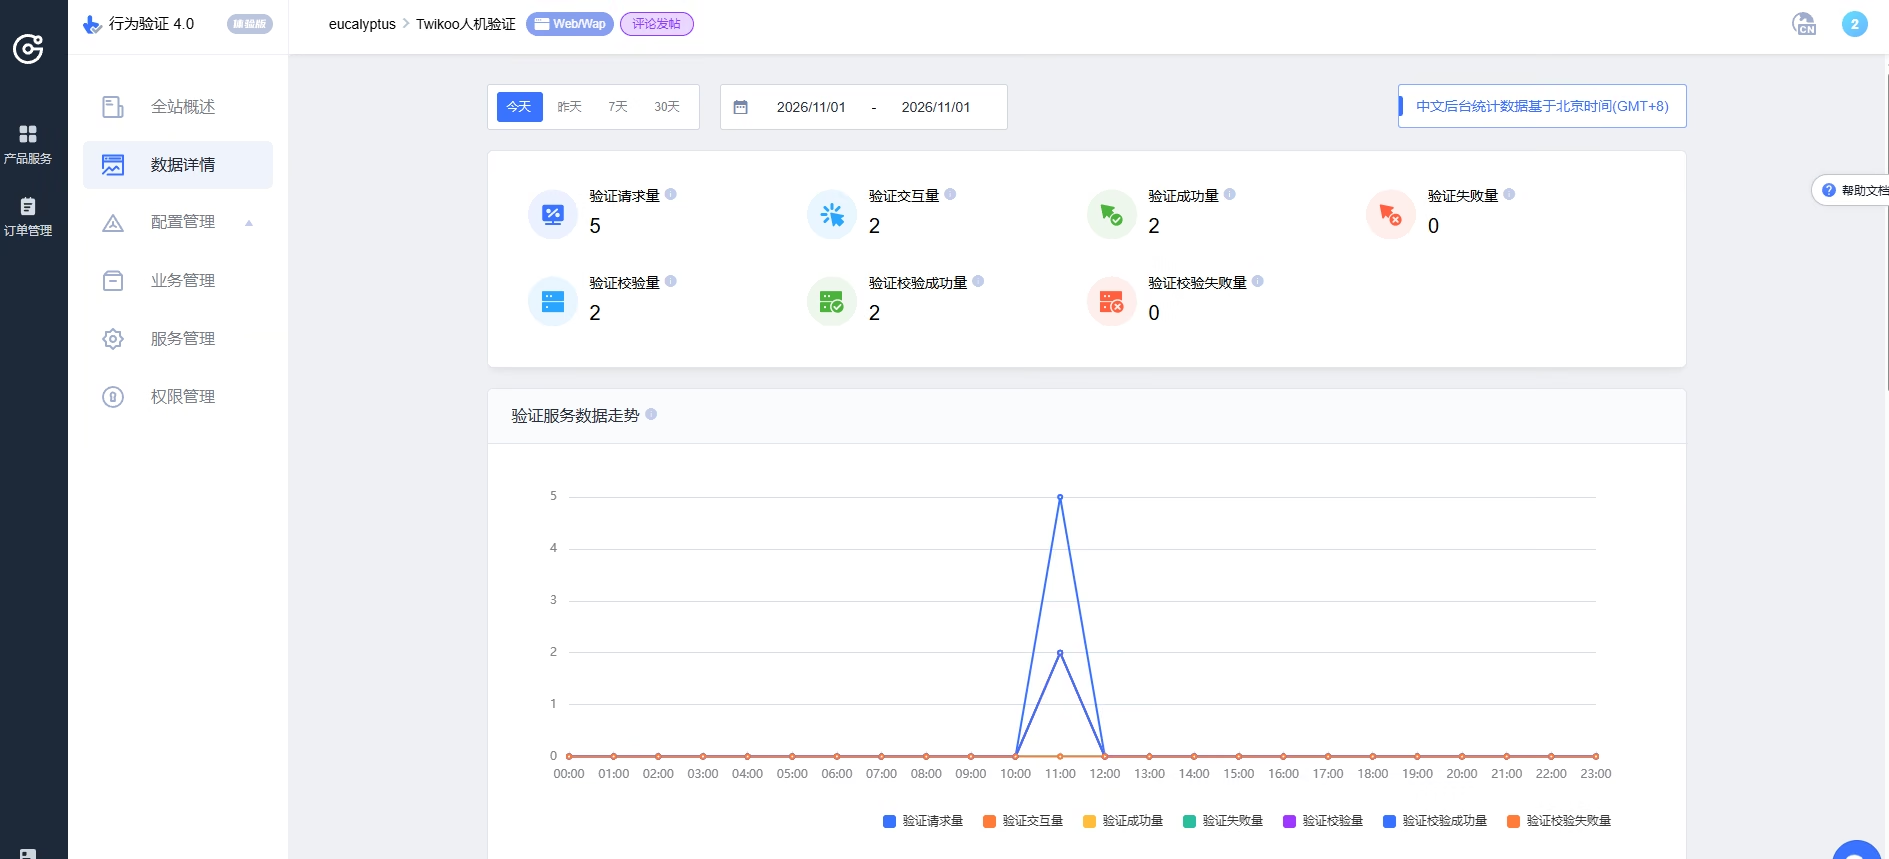
配好之后是能用的。「数据详情」里能看到验证请求数和成功数:
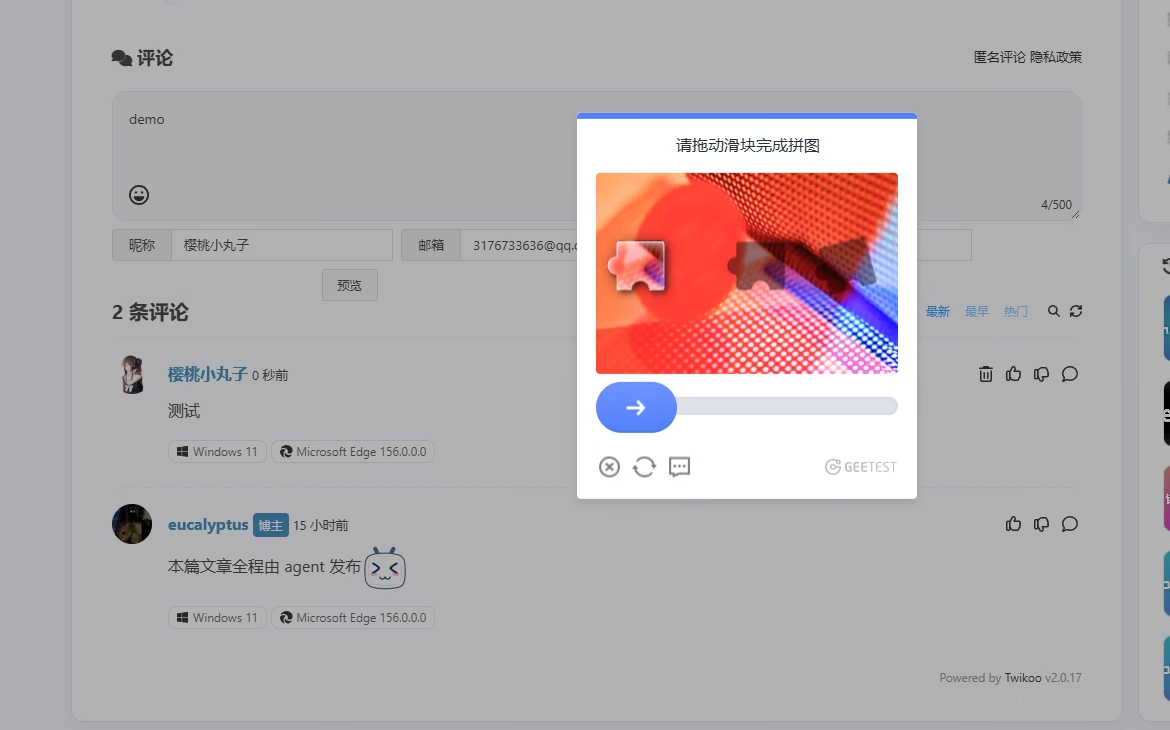
前台发评论则会弹出滑块:
但还是决定换掉,原因有三个:
- 30 天试用,到期要付费,后台不显示剩余额度,说不清哪天就失效了;
- 每次多一次跨网请求,读者要动手拖一下,多一步就少一点评论意愿;
- 它是”老大哥式”的验证——把访客的设备和行为数据交给第三方判断,对一个小博客来说有点重。
4.2 换成 Cap
Cap 的思路和传统验证码相反:不是让机器做不出、人一眼能做,而是让机器也做得出来,但每条都要花算力。
流程是这样:
1 | 点发送 |
配置只要三个字段,而且后两个留空:
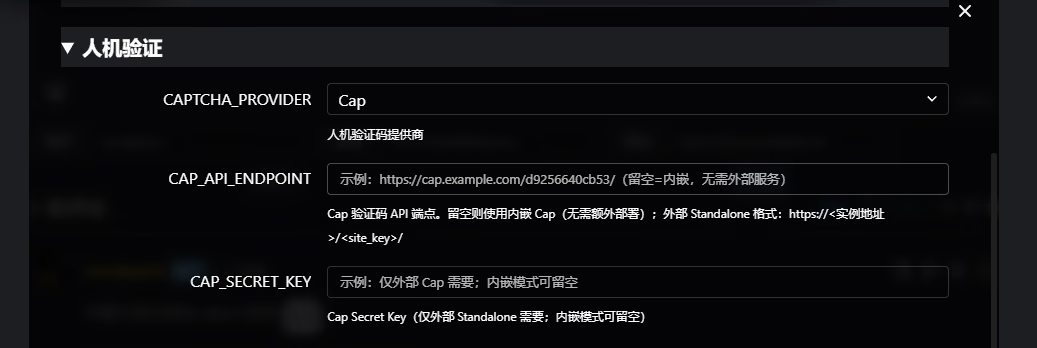
| 字段 | 值 |
|---|---|
CAPTCHA_PROVIDER |
Cap |
CAP_API_ENDPOINT |
留空(留空即内嵌模式) |
CAP_SECRET_KEY |
留空 |
留空是有讲究的:只要 CAP_API_ENDPOINT 为空,Twikoo 就会把 CAP_BUILTIN 置为 true,出题和判卷都走你自己的容器(日志里的 CAP_CHALLENGE / CAP_REDEEM),不需要任何第三方服务,也没有额度。
所以读者的体验就是转半秒进度圈,什么都不用点:
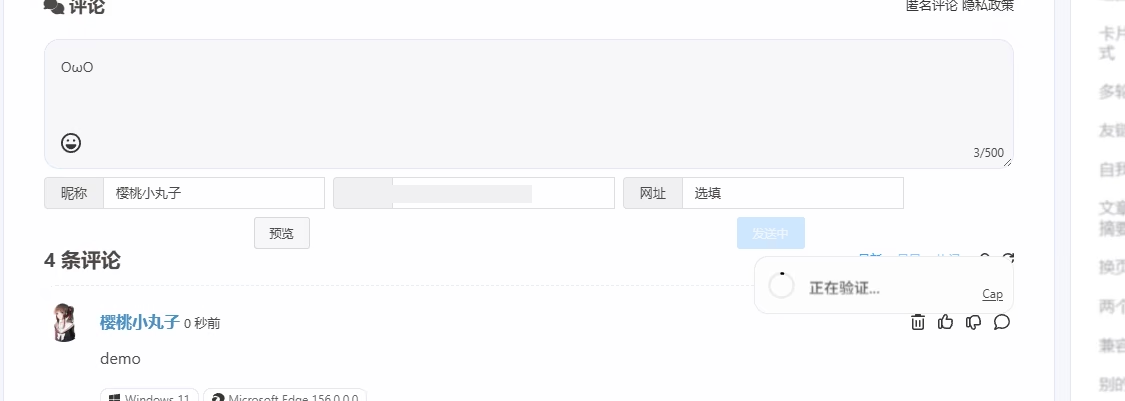
对脚本来说就难受了:token 一次性、不能预生成、必须真跑一遍 JS。昨晚那种 curl 直发的请求,连题都拿不到。
4.3 把前端组件也搬到本地
内嵌模式下,前端还需要一个 <cap-widget> 自定义元素来画界面。Twikoo 默认是从 cdn.jsdmirror.com ,可以把组件拿下来自己托管:
1 | # 1. 下载(放哪儿都行,这里放站点的 cdn 目录) |
然后在 themes/anzhiyu/layout/includes/additional-js.pug 里加一行:
1 | //- Cap 人机验证组件(本地自托管;已注册 cap-widget 时 Twikoo 会跳过 CDN) |
Twikoo 加载前会先查 customElements.get('cap-widget'),已经注册过就直接跳过 CDN,等于零外部依赖。
五、第二层:频率限制
两个字段,单位都是「条 / 10 分钟」:
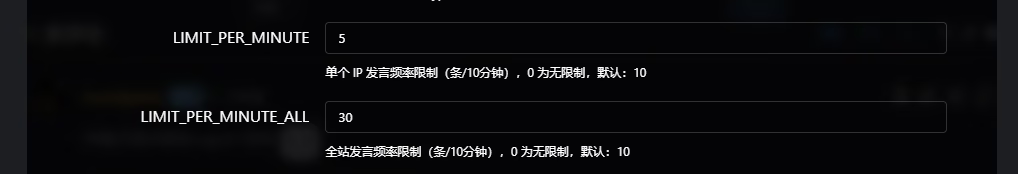
| 字段 | 值 | 含义 |
|---|---|---|
LIMIT_PER_MINUTE |
5 | 单个 IP 每 10 分钟最多 5 条 |
LIMIT_PER_MINUTE_ALL |
30 | 全站每 10 分钟最多 30 条 |
名字里带 MINUTE 但实际窗口是 10 分钟,别被误导。
单 IP 取 5:正常读者十分钟内连发 5 条已经很罕见,而脚本一秒钟就能发 3 条。全站取 30 是兜底——万一攻击者换 IP,也不至于把整个评论区打满。
六、第三层:词表
Twikoo 有两个词表,效果完全不同,很多人会搞混:
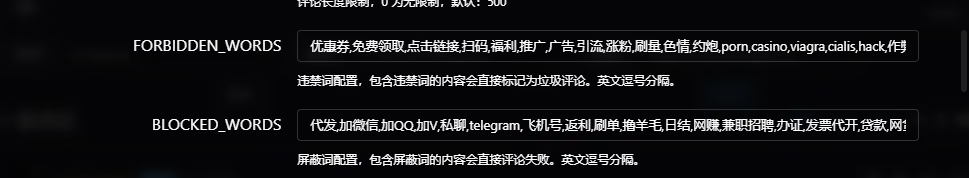
| 字段 | 命中后 | 适用 |
|---|---|---|
BLOCKED_WORDS |
评论直接提交失败 | 明确的广告词,几乎不会误伤 |
FORBIDDEN_WORDS |
评论照常发出,但标记为垃圾 | 模糊词,可能误伤,靠后台恢复 |
配好之后,带屏蔽词的评论会直接提交失败,前台提示「包含屏蔽词」,这条根本不会入库。
有两个细节值得记一下:
- 分隔符是英文逗号,中文逗号会被当成词的一部分。
- 匹配是”包含”,不分词,所以短词必误伤。比如别写
av——它会命中JavaScript;也别写”兼职””资源”这种正常讨论里常见的词。
所以我的做法是:长而独特的词进 BLOCKED_WORDS,模糊的、可能误伤的进 FORBIDDEN_WORDS。
七、第四层:让大模型做裁判
为什么是 LLM
Twikoo 支持四种外部检测,优先级是固定的:
1 | 腾讯云内容安全 > Akismet > Jev > LLM |
同时配多个不会叠加,只有最前面那个生效。
- 腾讯云:涉政涉黄这类合规判定最准,但要实名、要密钥、按量计费(25 元/万条);
- Akismet:个人博客免费,但中文库弱,而且评论内容要发到国外;
- LLM:填一个 API key 就行,中文语义好,价格比腾讯云还便宜。
对一个一天几条评论的博客来说,LLM 的性价比最高,而且不用多养一个云账号。
配置
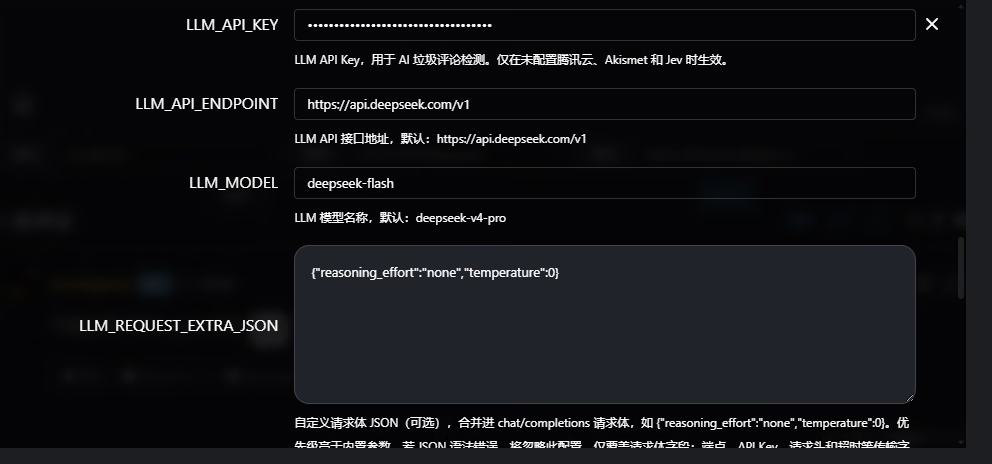
| 字段 | 值 |
|---|---|
LLM_API_KEY |
你的 DeepSeek key |
LLM_API_ENDPOINT |
留空(默认 https://api.deepseek.com/v1) |
LLM_MODEL |
留空,或用你账号可用的模型名 |
LLM_REQUEST_EXTRA_JSON |
{"reasoning_effort":"none","temperature":0} |
最后那个字段是合进请求体的额外参数:
temperature: 0:分类任务要稳定,同一条评论不能今天判垃圾、明天判正常;reasoning_effort: none:推理型模型默认会先吐一大段思考过程,JSON 混在中间就解析失败,关掉它直接出答案。
注意它是整段忽略语义:JSON 语法错一个字符,整条配置就失效了,而且不报错。
它按什么标准判
内置提示词里写得很明确,判垃圾的有六类:
- 商业广告 / 推广 / 买卖(代开发票、加微信、兼职、办证……)
- 昵称像广告 + 留了网址(正文再正常也判垃圾)
- 无意义灌水(顶顶顶、111111、asdfgh)
- 辱骂 / 侮辱性用语
- 网址字段里的可疑链接、SEO 垃圾
- 机器人式模板问候
判定范围是正文、昵称、网址三个字段全看。这就是它比关键词强的地方:正文写得人模人样,昵称是”加微信领福利”,还留了个外链——关键词一个都不命中,模型一眼看穿。
想调整尺度,可以自己写 LLM_SPAM_PROMPT,但它是整段替换,新提示词必须自带「只输出 JSON」的约束,否则会一直校验失败。
成本
一条评论几百 token,大约几毛钱一千条。一天 10 条评论的话,一年不到五块钱。
八、怎么验证真的生效了
反垃圾最怕的是”以为配了其实没配”。Twikoo 的两个特性让这件事特别隐蔽:
- 管理员发的评论跳过所有检测(
isAdminUser为 true 时直接isSpam = false),所以自己登录着测永远测不出来; - 检测失败是
try/catch静默吞掉的,日志记一行,评论照常显示。
所以只能看日志:
1 | docker logs twikoo --since 24h 2>&1 | grep -E "LLM 判定|垃圾评论检测异常|包含屏蔽词" |
正常的输出长这样:
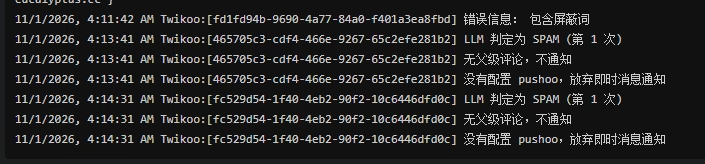
LLM 判定为 SPAM→ 通了垃圾评论检测异常→ 挂了(密钥错、欠费、模型名不对)
测试的时候记住:必须无痕窗口(非管理员身份),而且要发一条不含任何关键词的广告,否则会被第三层提前拦掉,根本走不到第四层。
九、最终配置
所有配置都在 Twikoo 后台 → 设置里,整理成一张表:
1 | 人机验证 |
小结
三层免费的规则 + 一层便宜的模型,加起来一年不到十块钱,把评论区的垃圾率压到了零。
几个值得记住的点:
- 极验能用,但更适合有预算的站;个人博客 Cap 足够,还免费;
- 管理员测不出反垃圾,一定要无痕;
- 关键词按”包含”匹配,短词必误伤;
- 外部检测只生效一个,别以为能叠加;
- 失败是静默的,定期 grep 一下日志;
- 验证码挡住的是脚本,语义层挡住的是人,两层缺一不可。
评论区清净了,才有心情继续写东西。