MySQL中的Character Set和Collation详解
MySQL中的Character Set和Collation详解
EucalyptusCharacter Set
Character Set(字符集) 是一组用于表示文本数据的符号及其对应编码规则的集合,它定义了数据库能够存储哪些字符(如英文字母、中文汉字、emoji 表情等)以及每个字符在底层如何转换为二进制字节进行存储;简单来说,字符集解决了“能存什么”的问题,是数据持久化的基础,而具体的显示和比较逻辑则由其关联的校对规则(Collation)来处理。
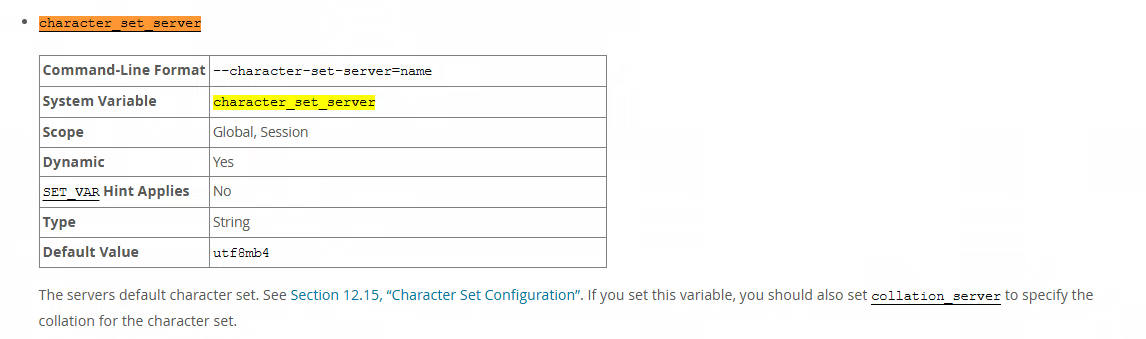
character_set_server(全局)
character_set_server 是 MySQL 服务器的全局默认字符集,它决定了当创建新的数据库(CREATE DATABASE)或表(CREATE TABLE)时,若未显式指定字符集,系统将自动采用的编码格式;虽然修改它会改变后续新建对象的默认行为,但不会影响已存在数据库或表的字符集,也不会直接改变当前客户端连接的 character_set_client 等会话级变量,因此它是控制数据存储底层编码的“基准线”,通常建议在配置文件中统一设置为 utf8mb4 以确保新业务数据的一致性。
https://dev.mysql.com/doc/refman/8.0/en/server-system-variables.html
取值
1 | show character set; |
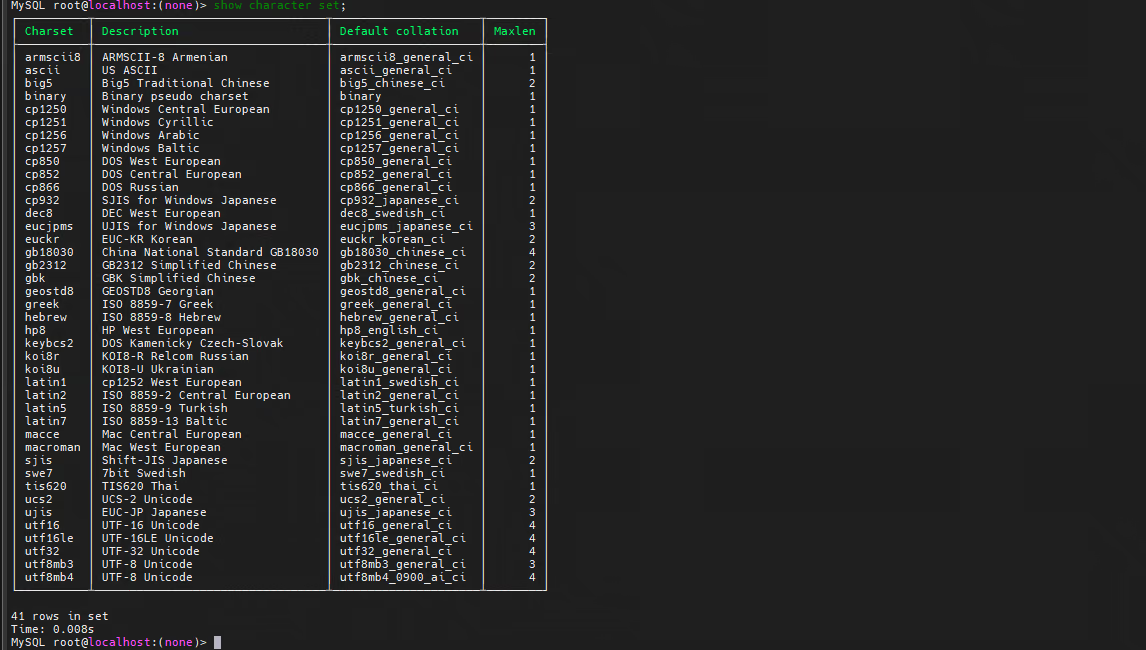
utf8mb4(推荐)
| 字符集 | 说明 | 适用场景 | |
|---|---|---|---|
utf8mb4 |
真正的 UTF-8。支持 1~4 字节变长编码 | 现代应用首选,完美支持 Emoji (😀) 和生僻字 |
⚠️ 避坑指南:在 MySQL 中,utf8 实际上是 utf8mb3 的别名,最多只支持 3 字节。它无法存储 Emoji 表情和部分生僻汉字。新项目请务必使用 utf8mb4。
latinl / cp1252 系列(西欧语言/历史遗留)
| 字符集 | 说明 | 适用场景 |
|---|---|---|
latin1 |
ISO-8859-1 西欧字符集,单字节固定长度 | MySQL 5.7 及更早版本的默认值;纯英文/西欧老项目 |
cp1252 |
Windows 西欧代码页,兼容 latin1 但多了几个符号 | 从 Windows 环境迁移的老数据 |
gbk / gb2312 / gb18030 系列(中文旧编码)
| 字符集 | 说明 | 适用场景 |
|---|---|---|
gbk |
扩展国标码,双字节固定长度 | 国内传统政企老系统、财务软件 |
gb2312 |
基础国标码,仅包含 6763 个汉字 | 极老旧的中文系统 |
gb18030 |
最新国家标准,兼容 gbk/gb2312,支持少数民族文字 | 需要符合国家信创标准的系统 |
其他常见字符集
| 字符集 | 说明 |
|---|---|
ascii |
纯 ASCII (0-127),单字节 |
binary |
二进制伪字符集,不做任何编码转换 |
ujis / sjis |
日文 EUC-JP / Shift_JIS 编码 |
euckr |
韩文 EUC-KR 编码 |
修改方式
1 | 1、动态修改 |
⚠️ 重要提醒
当你执行 set global character_set_server = ‘xxx’ 时,MySQL 会自动将 collation_server 切换到该字符集的默认排序规则。但你不能通过改字符集来指定一个非默认的排序规则(比如想让 server 用 utf8mb4_unicode_ci 而不是默认的 utf8mb4_0900_ai_ci),必须单独设置 collation_server。
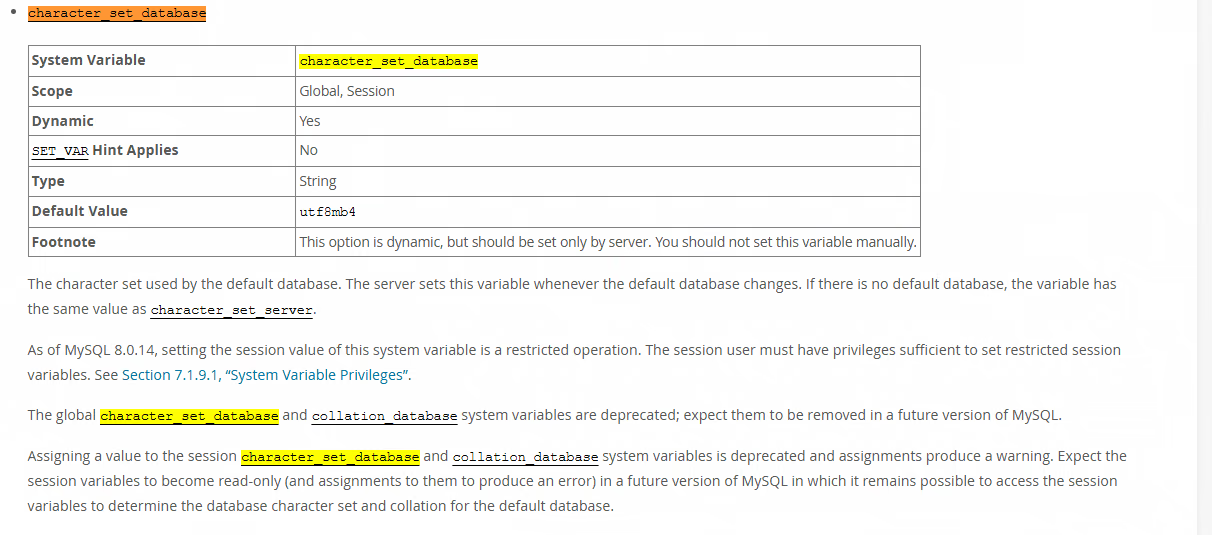
character_set_database
character_set_database 表示当前默认数据库(通过 USE 语句选中的库)的字符集;它主要用于在执行 CREATE TABLE 或 ALTER TABLE 时,如果未显式指定表的字符集,则自动继承该值作为表的默认字符集;需要注意的是,这个变量是动态变化的——当你切换数据库(USE db_name)时,它的值会随之改变为对应数据库定义的字符集,因此它反映的是“上下文环境”而非全局固定配置。
https://dev.mysql.com/doc/refman/8.0/en/server-system-variables.html
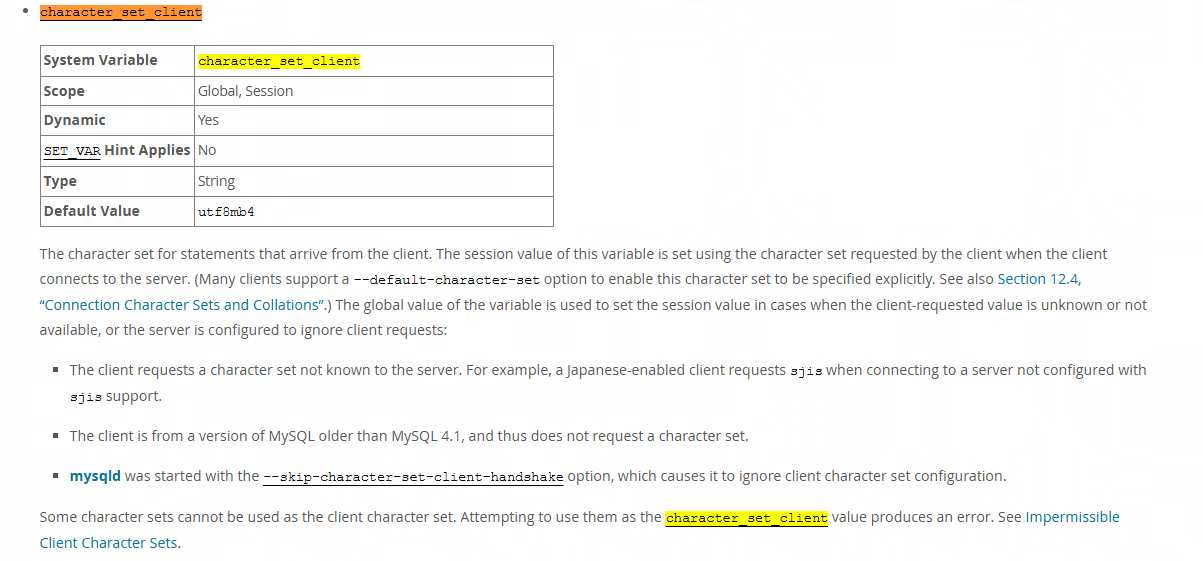
character_set_client
character_set_client 是 MySQL 用于标识客户端发送数据时所用编码的系统变量,它告诉服务器:“接下来我发过来的 SQL 语句和数据是按照什么字符集编码的”;如果该值与实际发送数据的编码不一致(例如客户端实际发送的是 UTF-8 字节流,但 character_set_client 被设为 latin1),MySQL 就会错误地解析字节序列,导致存入数据库的数据直接变成乱码,因此它是整个字符集转换链条的起点,必须与客户端程序或连接协议实际使用的编码严格保持一致。
https://dev.mysql.com/doc/refman/8.0/en/server-system-variables.html
1 | 1、动态 |
character_set_connection
character_set_connection 是 MySQL 处理字符数据的**“内部中转站”,它的核心作用是定义服务器在接收到客户端数据后、存入磁盘前,用于内部解析、比较和排序**的字符集编码;当它与 character_set_client 一致时(通常通过 SET NAMES 自动同步),数据可直接透传无需转码,从而避免乱码并提升性能,若两者不一致,MySQL 则会自动执行从 Client 到 Connection 的编码转换以确保数据逻辑的正确性。

character_set_results
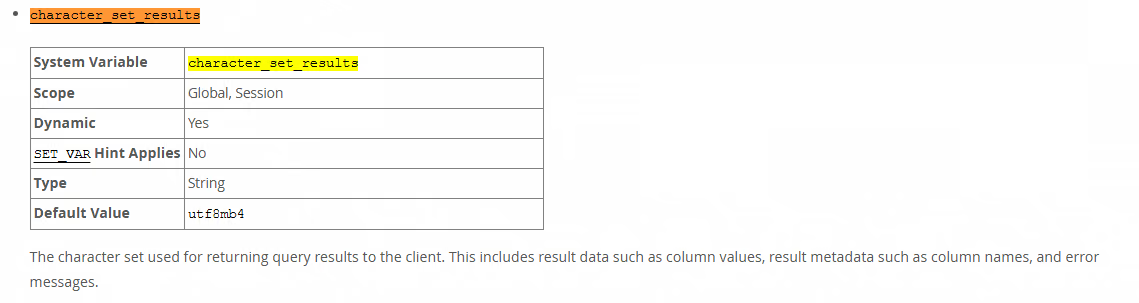
character_set_results 是 MySQL 控制数据返回方向的字符集变量,它决定了服务器在将查询结果发送给客户端之前所使用的编码格式;若该值与客户端程序实际解析数据的编码不一致(例如服务器返回 latin1 而客户端按 utf8 解析),即使数据库内部存储正确,客户端接收到的数据也会显示为乱码,因此通常需通过 SET NAMES 或连接参数将其与 character_set_client 保持一致以确保端到端的编码统一。
https://dev.mysql.com/doc/refman/8.0/en/server-system-variables.html
character_set_system
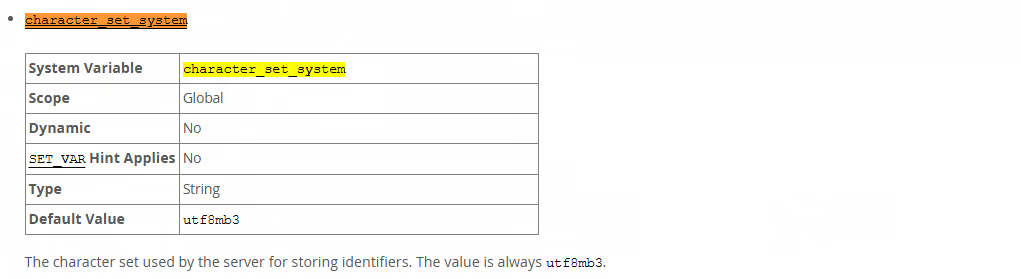
character_set_system 是 MySQL 内部系统元数据(如数据库名、表名、列名、视图名等)存储时使用的字符集,它始终固定为 utf8(utf8mb3),无法通过配置文件或命令修改;由于它仅用于标识对象名称而非存储用户业务数据,因此通常不需要用户关心,也不会导致业务数据的乱码问题。
https://dev.mysql.com/doc/refman/8.0/en/server-system-variables.html
character_set_filesystem
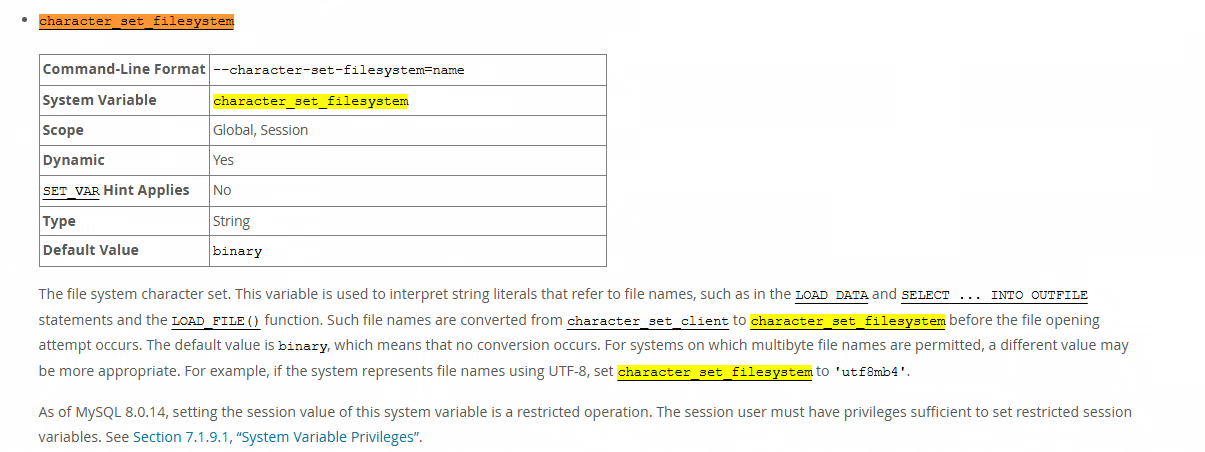
character_set_filesystem 用于指定 MySQL 在操作系统层面解析文件名(如数据文件、日志文件、导入/导出的临时文件)时所使用的字符集编码;它的主要作用是确保当数据库名或表名包含非 ASCII 字符(如中文)时,MySQL 能正确地将这些名称转换为操作系统文件系统所支持的编码格式,从而避免因文件名乱码导致无法找到文件或权限错误,默认值通常为 binary(即不进行转换,直接透传字节),在大多数 Linux 环境下无需修改,但在 Windows 或特殊文件系统场景中可能需要根据系统编码进行调整。
https://dev.mysql.com/doc/refman/8.0/en/server-system-variables.html
character_sets_dir
character_sets_dir 指定了 MySQL 字符集定义文件(即 .xml 配置文件,如 Index.xml 及各语言的具体定义)在服务器文件系统上的存储路径;MySQL 启动时会读取该目录下的文件来加载所有支持的字符集和校对规则信息,通常无需手动修改,除非你进行了非标准安装或需要自定义添加新的字符集定义。

https://dev.mysql.com/doc/refman/8.0/en/server-system-variables.html
Collation
Collation(校对规则) 是字符集(Character Set)的附属属性,它定义了一组具体的规则,用于确定字符串在数据库中如何进行比较、排序和分组;简单来说,字符集决定了“能存储哪些字符”,而校对规则决定了“这些字符谁大谁小、是否相等”(例如:是否区分大小写 case-sensitive、是否区分重音 accent-sensitive、以及多语言下的排序权重),每个字符集通常对应多个校对规则(如 utf8mb4_general_ci 表示不区分大小写,utf8mb4_bin 表示按二进制严格比较)。
collation_connection(会话级,可覆盖)
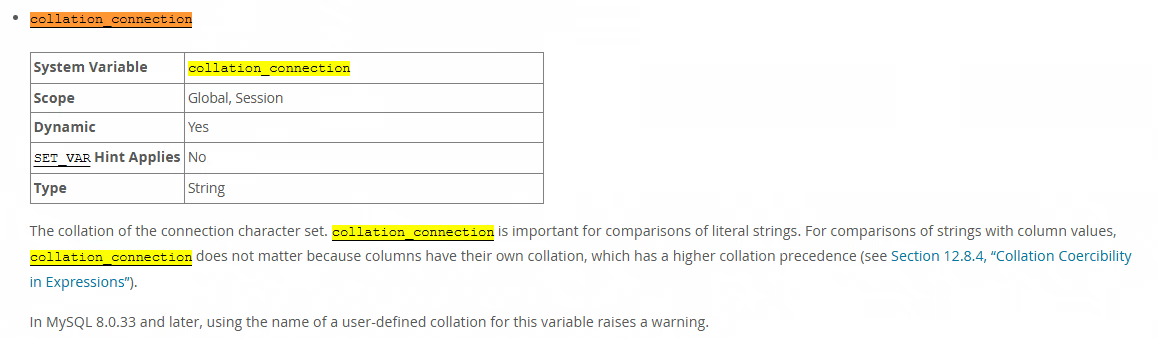
collation_connection 定义了在使用 character_set_connection 字符集进行**字符串比较、排序(ORDER BY)和分组(GROUP BY)**时所采用的具体规则(即校对规则);它决定了数据在内存中处理时的“大小写敏感性”和“重音敏感性”(例如,判断 ‘A’ 是否等于 ‘a’),通常会自动跟随 character_set_connection 的默认校对规则,若需特殊排序逻辑(如区分大小写),可单独设置此变量。
https://dev.mysql.com/doc/refman/8.0/en/server-system-variables.html
取值
1 | -- 查看所有可用的 collation |
utf8mb4(推荐)
| Collation | 说明 | 适用场景 |
|---|---|---|
utf8mb4_0900_ai_ci |
MySQL 8.0 默认。基于 Unicode 9.0,不区分大小写、不区分重音 | 现代应用首选 |
utf8mb4_0900_as_cs |
基于 Unicode 9.0,区分大小写、区分重音 | 需要精确匹配密码等 |
utf8mb4_0900_bin |
二进制比较,严格按码点排序 | 需要完全精确匹配 |
utf8mb4_unicode_ci |
基于 Unicode 4.0,不区分大小写 | 老项目迁移、兼容性要求 |
utf8mb4_general_ci |
简化版 Unicode 排序,速度快但不够精确 | 对排序精度要求不高、追求性能 |
utf8mb4_zh_0900_as_cs |
中文专用,按拼音排序 | 中文姓名/地址排序 |
utf8mb4_ja_0900_as_cs |
日文专用 | 日文应用 |
utf8mb3(旧版)
| Collation | 说明 |
|---|---|
utf8mb3_general_ci |
旧版 UTF-8 默认排序 |
utf8mb3_unicode_ci |
旧版 Unicode 排序 |
utf8_general_ci |
utf8mb3_general_ci 的别名 |
latinl(西欧语言)
| Collation | 说明 |
|---|---|
latin1_swedish_ci |
MySQL 历史默认值 |
latin1_general_ci |
通用西欧语言 |
latin1_bin |
二进制 |
修改方式
客户端和代码中没有指定时继承collation_server,不能直接到my.cnf中设置,因为collation_connection不在 mysqld 启动参数的白名单里

1 | 1、只对当前会话生效 |
另外即使通过set global设置后,如果客户端有单独设置,会reset重置collation_connection,出现会话级的collation_connection和全局的不一致
1 | 1、客户端连接的时候指定 |
collation_server(全局)
collation_server 是 MySQL 服务器的全局默认校对规则,它决定了当创建新的数据库或表时,若未显式指定校对规则,系统将自动采用的排序和比较逻辑(如是否区分大小写、是否忽略重音);它与 character_set_server 紧密绑定(每个字符集都有对应的默认校对规则),仅影响新建对象的默认行为,不会修改已存在数据的排序方式,通常建议将其设置为与业务需求匹配的规则(如 utf8mb4_unicode_ci 以支持更准确的多语言排序)。
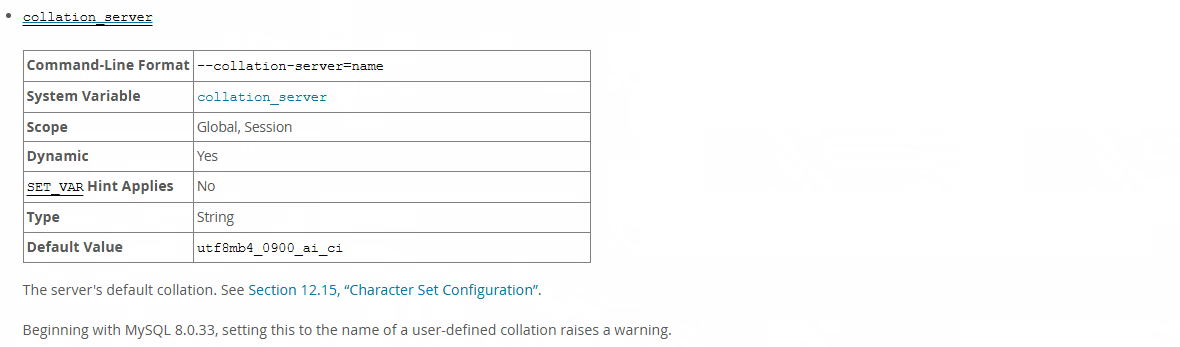
https://dev.mysql.com/doc/refman/8.0/en/server-system-variables.html
修改方式
1 | 1、修改当前会话 |
collation_database
collation_database 表示当前默认数据库(通过 USE 语句选中的库)的校对规则;它主要用于在执行 CREATE TABLE 或 ALTER TABLE 时,如果未显式指定表的校对规则,则自动继承该值作为表的默认校对规则;与 character_set_database 类似,这个变量也是动态变化的——当你切换数据库时,它的值会随之改变为对应数据库定义的校对规则,决定了在该库中新建表时默认的字符串比较和排序逻辑(如是否区分大小写)。
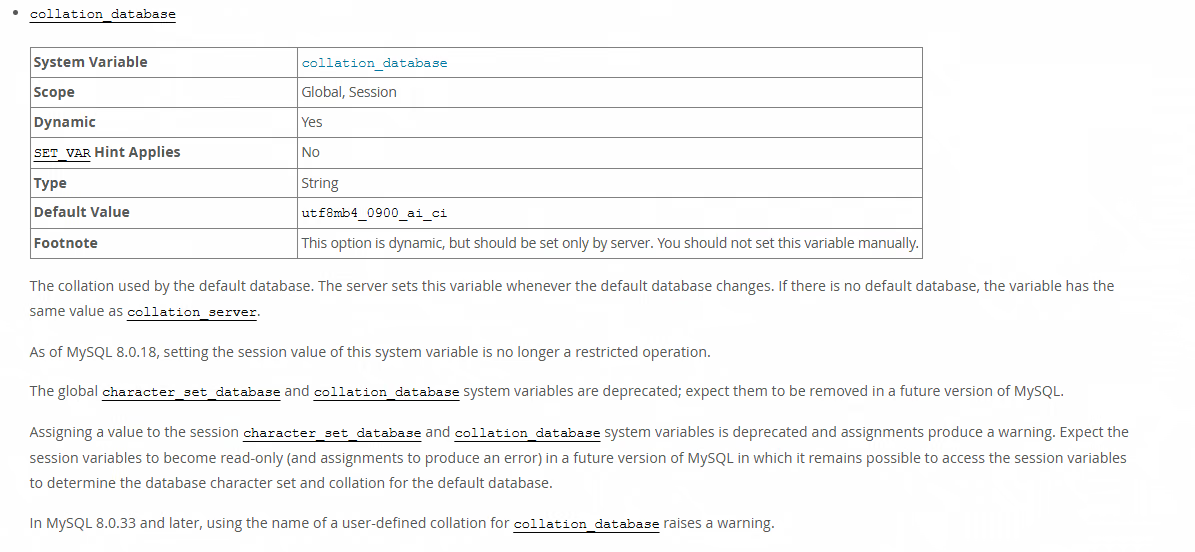
https://dev.mysql.com/doc/refman/8.0/en/server-system-variables.html
修改方式
1 | 1、修改当前会话 |
default_collation_for_utf8mb4
default_collation_for_utf8mb4 是 MySQL 8.0 引入的一个全局系统变量,用于指定当字符集为 utf8mb4 且未显式声明校对规则时的默认校对规则;在 MySQL 8.0 之前,utf8mb4 的默认校对规则是 utf8mb4_general_ci,而从 8.0 开始,为了提供更准确的多语言排序和比较支持,默认值变更为 utf8mb4_0900_ai_ci(基于 Unicode 9.0 标准),该变量允许管理员根据兼容性需求或特定业务场景自定义这一默认行为,从而影响所有新建数据库、表和列的默认排序逻辑。
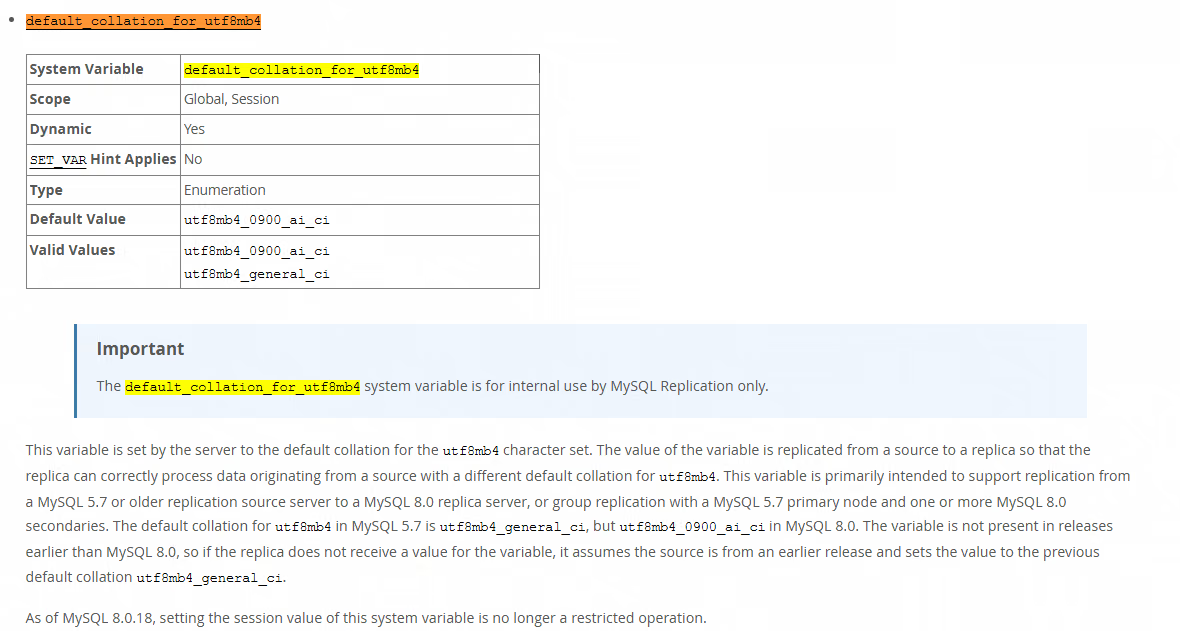
https://dev.mysql.com/doc/refman/8.0/en/server-system-variables.html
修改方式(会话级不建议修改)
1 | 1、修改全局默认值 |